Filtre « multi-step reply spam » de X : ce que montre le code (2026)
Le 4 septembre 2026, X a ajouté un filtre contre les chaînes d'auto-réponses sous des comptes de 1 000 abonnés et plus. Ce que fait son code public.
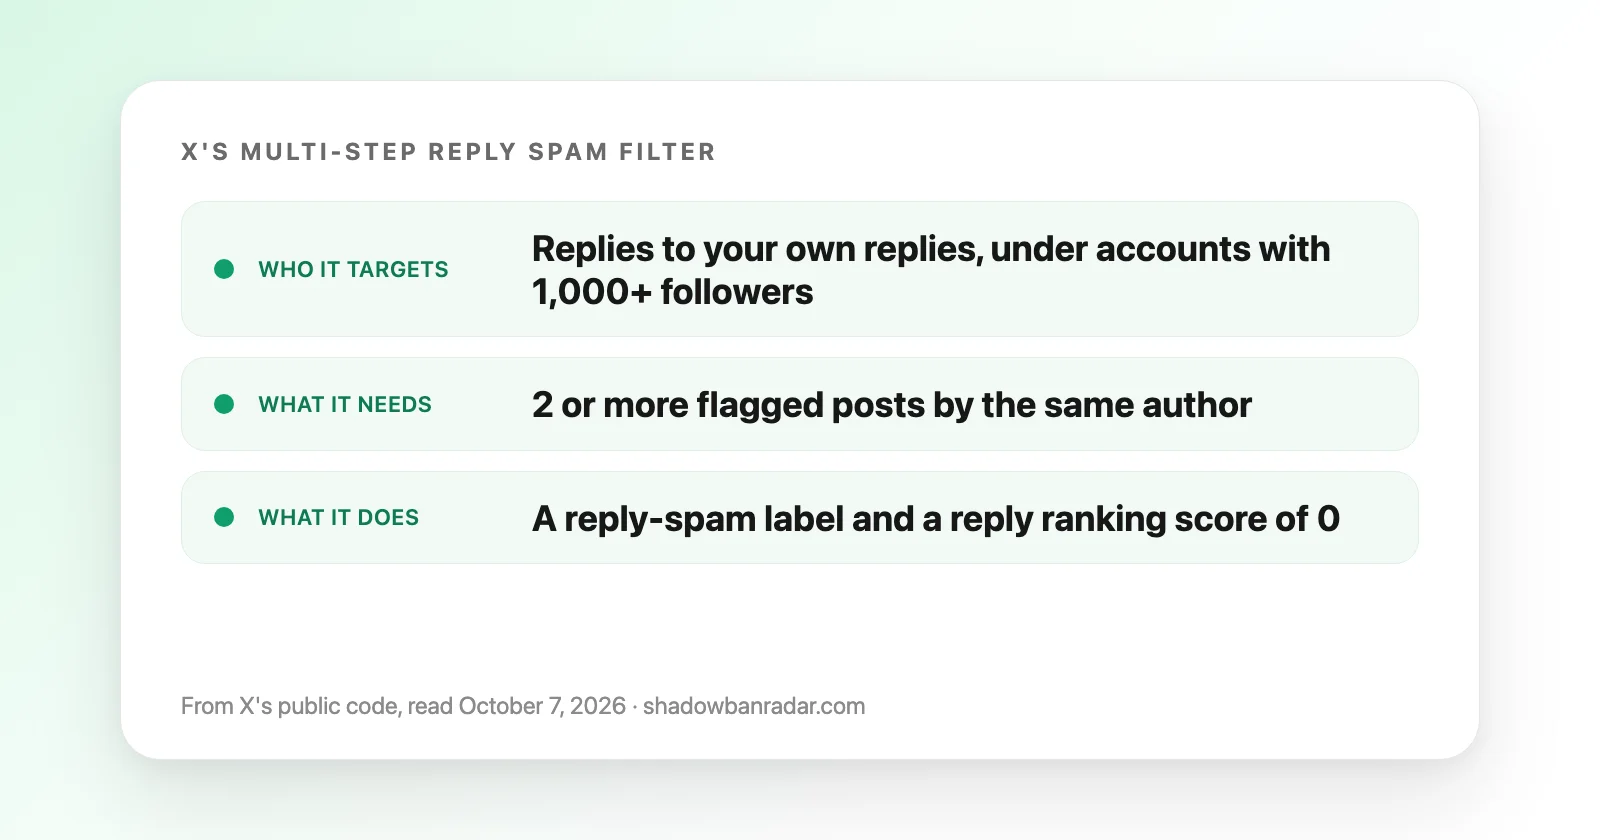
Le code open source de X contient un filtre, ajouté le 4 septembre 2026, qui vise les chaînes d'auto-réponses sous les posts de comptes d'au moins 1 000 abonnés. Quand un modèle d'IA signale au moins 2 posts du même auteur dans une telle chaîne, le code de X donne à chaque post signalé une étiquette reply spam et un score de classement de la réponse de 0.
Qu'a ajouté X à son code open source le 4 septembre 2026 ?
Le dépôt public xai-org/x-algorithm a reçu le 4 septembre 2026 un nouveau flux anti-spam de réponses, multi_step_reply_spam. Le commit a ajouté quatre fichiers dans grox/flows/reply_spam/ :
plan_multi_step_reply_spam.pyenchaîne 4 étapes : un filtre d'éligibilité, l'hydratation des médias, la détection du spam et une étape d'écriture.task_multi_step_reply_spam.pycontient le filtre, l'étape de détection et l'étape d'écriture.classifier_multi_step_reply_spam.pyconstruit le fil que lit le modèle, analyse sa réponse et applique 3 garde-fous.state_multi_step_reply_spam.pystocke le résultat : une liste d'identifiants de posts signalés et une raison.
Le README de X décrit le dossier grox/ comme du code qui s'exécute à mesure que les posts sont publiés, avec des classifieurs pour des catégories comme le spam. Le nouveau plan est enregistré auprès des mêmes générateurs de flux que les autres flux de classement des réponses de X.
Le fichier de tâches a été modifié de nouveau le 8 septembre 2026 : son étape d'écriture appelle désormais une seule fonction de publication au lieu de deux écritures séparées. La valeur écrite reste 0.0.
Quelles réponses le filtre « multi-step reply spam » peut-il viser ?
Gratuit, sans connexion, résultat en quelques secondes.
Le filtre (TaskMultiStepReplySpamFilter) ne retient une réponse que si toutes ces conditions sont réunies :
- Le post est une réponse qui a des ancêtres, et aucun d'eux n'a été supprimé.
- Son parent direct est un post du même auteur : le compte se répond à lui-même.
- Il se situe au moins 2 niveaux sous le post racine.
- Son auteur n'est pas l'auteur du post racine.
- L'auteur du post racine a au moins 1 000 abonnés (
FOLLOWER_COUNT_THRESHOLD_FOR_SPAM_DETECTION = 1000). En dessous, le code écarte la réponse avec la raisonlow_blast_radius.
La plus petite forme qui qualifie est un post d'un autre compte, une réponse du compte évalué, puis une seconde réponse de ce même compte à sa propre première réponse. Le filtre ne regarde jamais le nombre d'abonnés de l'auteur de la réponse.
Une réponse dont le parent direct appartient à quelqu'un d'autre est écartée (parent_not_same_author). Il en va de même de toute réponse sous le propre post de son auteur (same_user_reply_as_root).
Quels comptes le filtre exclut-il ?
Le filtre « multi-step reply spam » de X écarte 5 types de cas avant qu'aucun modèle ne tourne :
- Les réponses écrites par les comptes Grok ou Gork.
- Les auteurs marqués high page rank (version 2), vérifiés avec
is_high_page_rank_v2_user. - Les auteurs portant un badge gris, vérifiés avec
is_grey_badge_user. - Les réponses sous un auteur racine de moins de 1 000 abonnés.
- Les fils dont un post ancêtre a été supprimé, ou dont un post n'a pas de fiche d'auteur.
Ces fichiers ne définissent ni « high page rank » ni « badge gris ».
Comment le modèle décide-t-il ce qui est du spam ?
Le code de X montre ce que reçoit le modèle et ce qui se passe après sa réponse, mais pas les critères qu'il applique. Le scoreur est lié à l'identifiant de modèle oai-gemma4-26b-2, défini dans constants.py.
Le modèle lit :
- le profil de l'auteur de la réponse (nom, identifiant, bio et lieu du profil) ;
- le fil sous forme de posts numérotés, où le Post 0 est le post racine, marqué « never flag », et le dernier post est marqué « the reply being evaluated » ;
- pour chaque post, l'identifiant, le nombre d'abonnés, le nom affiché, le texte, les URL et jusqu'à 2 médias ;
- la bio de l'auteur racine, ajoutée au post racine.
Un fil de plus de 10 ancêtres est réduit aux 5 premiers et aux 5 derniers (MAX_THREAD_SIZE = 10). Le modèle répond en JSON : les index des posts qu'il juge être du spam, et une raison.
Le prompt lui-même n'est pas public. prompts.py charge un gabarit nommé multi_step_reply_spam_system.j2, absent du dépôt, et le commentaire du fichier indique que les prompts sont exclus pour limiter la manipulation du système. Le README de X range les prompts de Grox parmi les fichiers qu'il ne publie pas.
Quels garde-fous suivent la réponse du modèle ?
Trois contrôles s'exécutent dans cet ordre, et chacun peut effacer les signalements :
- Si la réponse la plus récente ne figure pas parmi les posts signalés, tous les signalements sont abandonnés.
- Les posts signalés écrits par d'autres auteurs sont retirés.
- S'il reste exactement 1 post signalé, il est abandonné.
Une sanction exige donc au moins 2 posts signalés du même auteur, réponse la plus récente comprise.
Que se passe-t-il pour une réponse signalée par le filtre ?
Pour chaque post signalé du fil, le code de X applique une étiquette de sécurité reply spam et publie un score de classement de la réponse de 0.0. L'étape d'écriture (TaskWriteMultiStepReplySpamReplyRanking) est désactivée hors production par DisableTaskForNonProd.
Pour chaque post signalé, le code :
- applique l'étiquette de sécurité
RiskyHighVizReply, sauf si l'auteur est high page rank, porte un badge gris ou est un compte de test (un score de crédibilité de 62 ou plus compte comme high page rank quand ce score existe) ; - publie un score de classement de la réponse de 0.0 avec la raison donnée par le modèle, réduite à ses 500 derniers caractères.
Le principal scoreur de classement des réponses du même dossier refuse tout score hors d'une grille de 0 à 3 : 0 est donc la valeur la plus basse de cette échelle. Quand un post porte un 0, l'étape d'écriture standard du classement des réponses ignore tout nouveau score qui n'est pas inférieur à celui déjà stocké.
Ces fichiers agissent sur des posts pris un à un. Ils ne suspendent pas le compte et ne l'étiquettent pas dans son ensemble.
Ce que les fichiers publiés ne montrent pas
Le dépôt ne montre pas comment une vue de conversation utilise le score ou l'étiquette : une recherche du nom du score ne le trouve que dans le dossier reply_spam. Le nom d'étiquette RiskyHighVizReply n'apparaît nulle part dans le dossier under-the-hood du dépôt, liste des étiquettes comprise : le code publié ne montre donc aucune entrée pour elle dans Under the Hood.
Comment savoir si vos réponses sont touchées ?
Pour savoir si vos réponses sont touchées, regardez où elles se placent dans la conversation. Un reply deboosting (déclassement des réponses) signifie que vos réponses sont reléguées en bas d'une conversation ou cachées derrière « Afficher plus de réponses ».
Shadowban Radar définit ce test de l'extérieur. Le déclassement des réponses est détecté quand X sert une réponse dans la conversation lue par ordre chronologique, mais la laisse hors de l'affichage par défaut de cette même conversation. La page sur le reply deboosting explique comment vérifier à la main.
Un test gratuit sur Shadowban Radar lance ce contrôle sur n'importe quel identifiant public, sans connexion. Il montre la position d'une réponse, pas la cause. Une réponse mal classée peut venir de plusieurs signaux : le test ne peut donc pas dire si ce filtre l'a signalée.
Une réponse absente de la conversation est une autre restriction, un ghost ban.
Que suggère le code pour s'en protéger ?
X n'a pas publié les critères du modèle : ces points découlent donc uniquement des conditions du filtre.
- Le dire une seule fois. Le filtre n'agit que si au moins 2 posts du même auteur sont signalés, et une réponse isolée sous le post de quelqu'un d'autre ne peut pas qualifier. Fusionner plusieurs courtes réponses en une seule évite la chaîne que cherche le filtre.
- Mettre le détail supplémentaire dans son propre post. Une suite, un lien ou une explication plus longue peuvent aller dans votre propre post ou fil : les réponses sous votre propre post ne sont jamais évaluées (
same_user_reply_as_root). - Répondre aux gens, pas à soi-même. Une réponse dont le parent direct est le post d'un autre compte est hors du filtre (
parent_not_same_author). - Une chaîne est jugée dans son ensemble. Le modèle lit tout le fil d'un coup, et chaque post signalé du même auteur reçoit son propre score de 0.
Les fichiers reply_spam ne contiennent aucune étape qui lève une étiquette ou relève un 0 une fois écrit.
Sources
Lu le 7 octobre 2026 dans le dépôt xai-org/x-algorithm, au commit 78460ca. Les 4 fichiers du filtre ont été ajoutés dans le commit 9b0dc31 le 4 septembre 2026.
- plan_multi_step_reply_spam.py : les 4 étapes et leur ordre.
- task_multi_step_reply_spam.py : éligibilité, détection et écriture.
- classifier_multi_step_reply_spam.py : le fil donné au modèle et les 3 garde-fous.
- state_multi_step_reply_spam.py : le résultat stocké.
- task_write.py : la fonction d'étiquette et l'écriture standard du classement des réponses.
- README.md : la description de
grox/et la liste des fichiers non publiés. - Commit 9b0dc31 : 4 septembre 2026.
Shadowban Radar n'est pas affilié à X Corp. Pour comprendre le lien entre le rapport de X et un test en direct, voir Under the Hood de X.