X 的“multi-step reply spam”过滤器:代码里能看到什么(2026)
2026 年 9 月 4 日,X 新增了一个过滤器,针对粉丝 1,000 以上账号下的自我回复链。解读其公开代码判断什么、做什么。
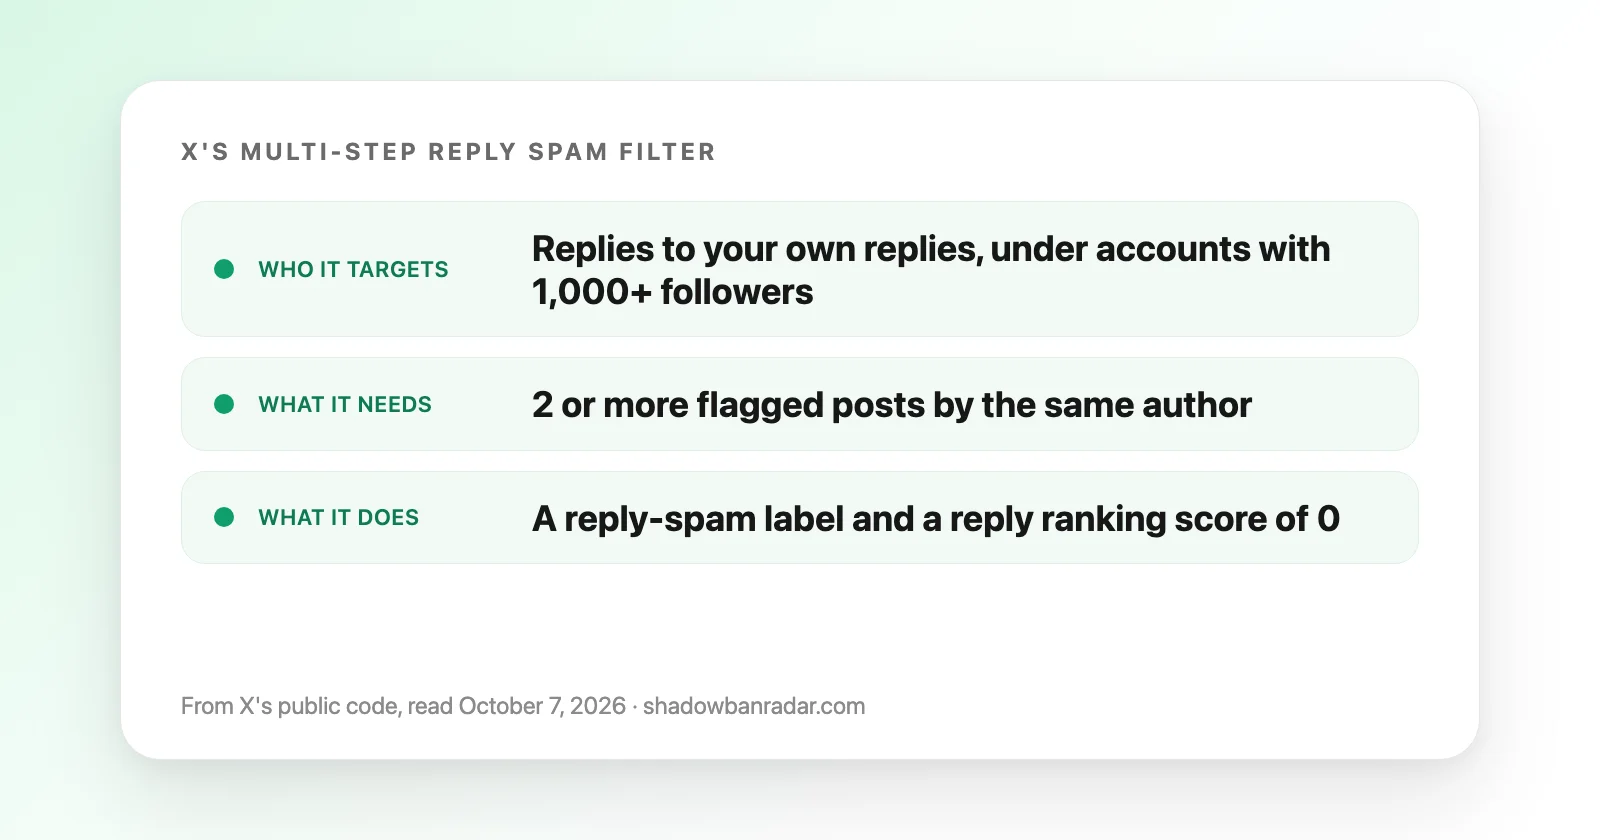
X 的开源代码里有一个 2026 年 9 月 4 日加入的过滤器,针对粉丝至少 1,000 的账号帖子下的自我回复链。当 AI 模型把这样一条链中同一作者的至少 2 条帖子标记为垃圾内容时,X 的代码会给每条被标记的帖子加上 reply spam 标签,并给出 0 分的回复排序分数。
X 在 2026 年 9 月 4 日给开源代码增加了什么?
X 的公开仓库 xai-org/x-algorithm 在 2026 年 9 月 4 日新增了一个回复垃圾内容流程 multi_step_reply_spam。这次提交在 grox/flows/reply_spam/ 中新增了四个文件:
plan_multi_step_reply_spam.py串起 4 个步骤:资格过滤、媒体加载、垃圾内容检测和写入。task_multi_step_reply_spam.py包含过滤器、检测步骤和写入步骤。classifier_multi_step_reply_spam.py构建模型要读的讨论串,解析模型的回答,并执行 3 项保护措施。state_multi_step_reply_spam.py保存结果:被标记帖子的 ID 列表和一条理由。
X 的 README 把 grox/ 文件夹描述为在帖子发布时运行的代码,包含针对垃圾内容等类别的分类器。这个新流程和 X 其他回复排序流程注册在同样的流式生成器上。
任务文件在 2026 年 9 月 8 日又被修改过:写入步骤现在调用一个发布函数,不再是两次单独的写入。它写入的值仍然是 0.0。
“multi-step reply spam”过滤器会针对哪些回复?
免费,无需登录,几秒出结果。
过滤器(TaskMultiStepReplySpamFilter)只有在以下条件全部满足时才会选中一条回复:
- 该帖子是有祖先的回复,且没有任何祖先被删除。
- 它的直接上级是同一作者的帖子:账号在回复自己。
- 它位于根帖之下至少 2 层。
- 它的作者不是根帖的作者。
- 根帖作者的粉丝至少 1,000(
FOLLOWER_COUNT_THRESHOLD_FOR_SPAM_DETECTION = 1000)。低于这个数,代码会以low_blast_radius为理由跳过该回复。
满足条件的最小形态是:另一个账号的一条帖子,被评估账号的一条回复,以及同一账号对自己第一条回复的第二条回复。过滤器从不查看回复者自己的粉丝数。
直接上级属于别人的回复会被跳过(parent_not_same_author)。回复者自己帖子下的任何回复也一样(same_user_reply_as_root)。
过滤器会放过哪些账号?
X 的 multi-step reply spam 过滤器在任何模型运行之前,会跳过 5 类情况:
- Grok 或 Gork 账号写的回复。
- 被标为 high page rank(第 2 版)的作者,通过
is_high_page_rank_v2_user检查。 - 带灰色徽章的作者,通过
is_grey_badge_user检查。 - 根帖作者粉丝不足 1,000 的回复。
- 祖先帖子已被删除,或某条帖子没有作者记录的讨论串。
这些文件没有定义“high page rank”和“灰色徽章”。
模型如何判断什么是垃圾内容?
X 的代码展示了模型收到什么,以及它回答之后发生什么,但没有展示它使用的判断标准。评分器绑定的模型标识是 oai-gemma4-26b-2,定义在 constants.py 中。
模型会读到:
- 回复作者的资料(名称、用户名、简介和资料中的所在地);
- 以编号帖子呈现的讨论串,其中“Post 0”是根帖,标注为“never flag”,最后一条标注为“the reply being evaluated”;
- 每条帖子的用户名、粉丝数、显示名称、正文、URL,以及最多 2 个媒体项;
- 根帖作者的简介,附在根帖上。
祖先超过 10 条的讨论串会被裁剪为前 5 条和后 5 条(MAX_THREAD_SIZE = 10)。模型以 JSON 作答:它判定为垃圾内容的帖子的序号,以及一条理由。
提示词本身没有公开。prompts.py 会加载名为 multi_step_reply_spam_system.j2 的模板,但它不在仓库中,该文件自带的注释说明排除提示词是为了降低系统被钻空子的风险。X 的 README 也把 Grox 的提示词列入不公开的文件。
模型回答之后有哪些保护措施?
三项检查按以下顺序运行,每一项都可能抹掉标记:
- 如果最新的回复不在被标记的帖子中,所有标记都会被丢弃。
- 其他作者所写的被标记帖子会被移除。
- 如果只剩下恰好 1 条被标记的帖子,它会被丢弃。
因此,处罚至少需要同一作者的 2 条被标记帖子,且其中包括最新的回复。
被过滤器标记的回复会怎样?
对讨论串中的每条被标记帖子,X 的代码都会加上 reply spam 安全标签,并发布 0.0 的回复排序分数。写入步骤(TaskWriteMultiStepReplySpamReplyRanking)通过 DisableTaskForNonProd 在非生产环境中被禁用。
对每条被标记的帖子,代码会:
- 加上安全标签
RiskyHighVizReply,除非作者是 high page rank(有分数时,信誉分 62 或以上算作 high page rank)、带灰色徽章或是测试用户; - 发布 0.0 的回复排序分数,并附上模型给出的理由,理由只保留最后 500 个字符。
同一文件夹里的主要回复排序评分器,会拒绝 0 到 3 区间之外的任何分数,所以 0 是这个量表上的最低值。一条帖子一旦得到 0,标准的回复排序写入步骤就会跳过任何不低于已存分数的新分数。
这些文件作用于单条帖子,不会封停账号,也不会给账号整体加标签。
公开文件没有展示的内容
仓库没有展示对话视图如何使用这个分数或标签:搜索该分数的名称,只会在 reply_spam 文件夹里找到它。标签名 RiskyHighVizReply 在仓库的 under-the-hood 文件夹里也没有出现,标签列表中同样没有,所以已公开的代码没有显示 Under the Hood 中有它的条目。
如何知道您的回复是否受到影响?
要知道您的回复是否受到影响,就看它们在对话中的位置。回复降权(回复排序降低)是指您的回复被推到对话底部,或藏在“显示更多回复”之后。
Shadowban Radar 从外部定义这项检测。当 X 在按时间顺序读取的对话中显示某条回复,却在同一对话的默认视图中将其排除时,即检测到回复排序降低。reply deboosting 页面说明了如何手动检查。
在 Shadowban Radar 上做一次免费检测,可对任何公开用户名运行这项测试,无需登录。它显示的是回复的位置,而不是原因。回复排名靠后可能来自多种信号,所以检测无法判断是不是这个过滤器标记了它。
如果回复在对话中完全消失,那是另一种限制,即 ghost ban。
从代码看,可以怎么做?
X 没有公开模型的判断标准,所以以下几点只来自过滤器的条件。
- 一件事只说一次。过滤器只在同一作者至少有 2 条帖子被标记时才起作用,别人帖子下的单独一条回复不可能满足条件。把几条短回复合并成一条,就能避开过滤器要找的回复链。
- 把补充内容放进自己的帖子。后续说明、链接或较长的解释,可以放在自己的帖子或讨论串里:自己帖子下的回复从不会被评估(
same_user_reply_as_root)。 - 回复别人,而不是回复自己。直接上级是其他账号帖子的回复,不在过滤器范围内(
parent_not_same_author)。 - 一条回复链会被整体判断。模型一次读完整个讨论串,同一作者每条被标记的帖子都会各自获得 0 分。
reply_spam 的文件中没有任何步骤可以撤掉标签,或在写入 0 之后再把它调高。
来源
2026 年 10 月 7 日读取自 xai-org/x-algorithm 仓库,提交为 78460ca。这 4 个过滤器文件于 2026 年 9 月 4 日在提交 9b0dc31 中新增。
- plan_multi_step_reply_spam.py:4 个步骤及其顺序。
- task_multi_step_reply_spam.py:资格、检测和写入步骤。
- classifier_multi_step_reply_spam.py:交给模型的讨论串和 3 项保护措施。
- state_multi_step_reply_spam.py:保存的结果。
- task_write.py:打标签的函数和标准的回复排序写入。
- README.md:
grox/的说明和未公开文件的列表。 - 提交 9b0dc31:2026 年 9 月 4 日。
Shadowban Radar 与 X Corp 没有关联。X 官方报告与实时检测的关系,见 X 的 Under the Hood。