Filtro «multi-step reply spam» de X: qué muestra su código (2026)
El 4 de septiembre de 2026 X añadió un filtro contra cadenas de autorrespuestas bajo cuentas con 1.000 seguidores o más. Lo que hace su código público.
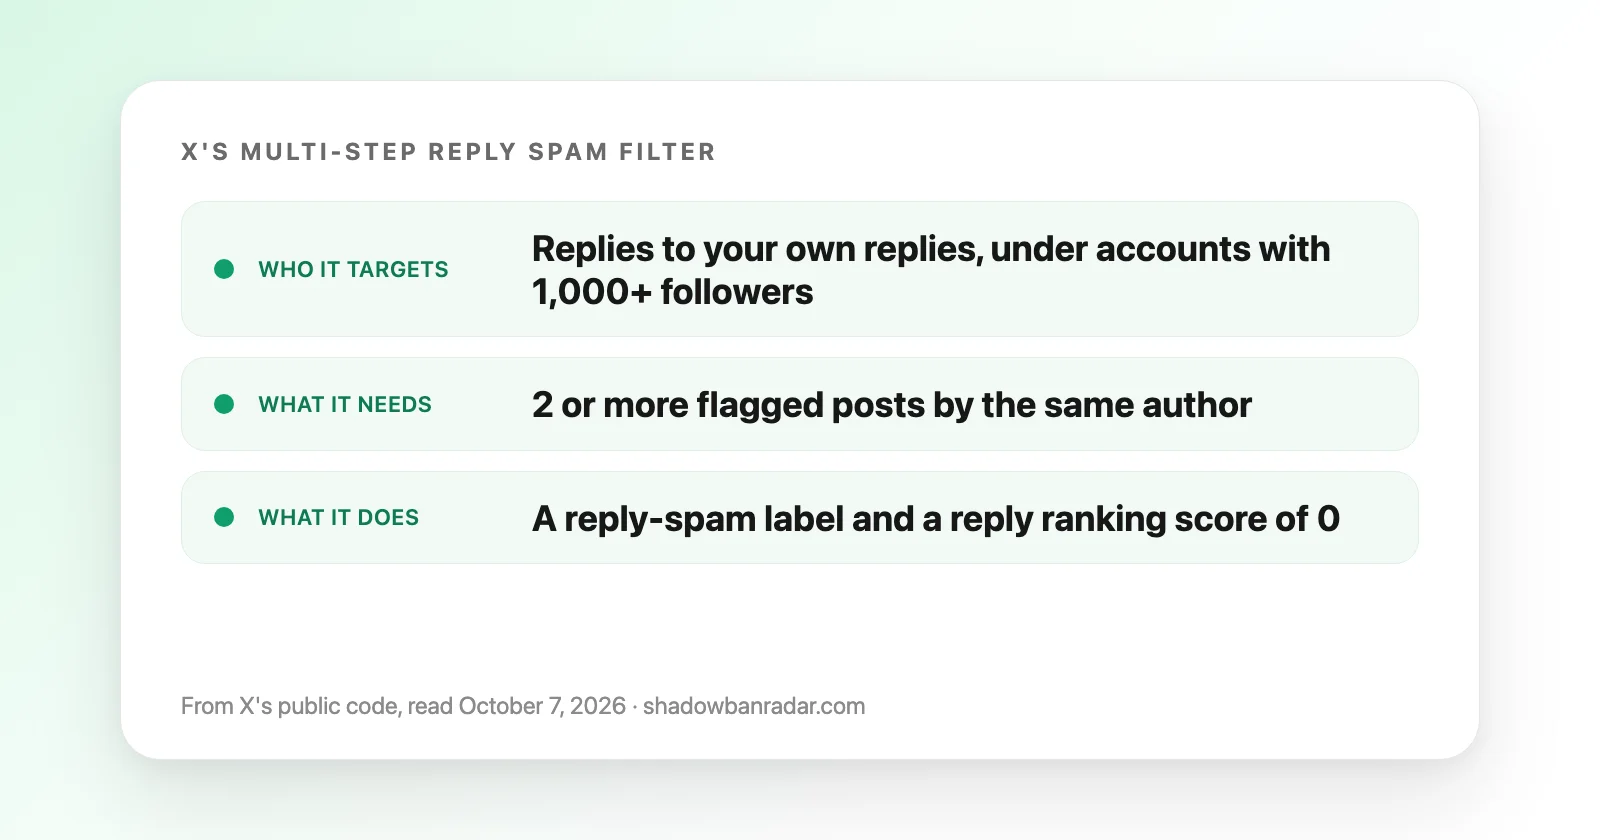
El código abierto de X contiene un filtro, añadido el 4 de septiembre de 2026, dirigido a las cadenas de autorrespuestas bajo publicaciones de cuentas con al menos 1.000 seguidores. Cuando un modelo de IA señala al menos 2 publicaciones del mismo autor en una cadena así, el código de X da a cada una una etiqueta de reply spam y una puntuación de clasificación de la respuesta de 0.
¿Qué añadió X a su código abierto el 4 de septiembre de 2026?
El repositorio público xai-org/x-algorithm incorporó el 4 de septiembre de 2026 un nuevo flujo contra el spam de respuestas, multi_step_reply_spam. El commit añadió cuatro archivos en grox/flows/reply_spam/:
plan_multi_step_reply_spam.pyencadena 4 pasos: un filtro de elegibilidad, la carga de medios, la detección de spam y un paso de escritura.task_multi_step_reply_spam.pycontiene el filtro, el paso de detección y el paso de escritura.classifier_multi_step_reply_spam.pyconstruye el hilo que lee el modelo, interpreta su respuesta y aplica 3 salvaguardas.state_multi_step_reply_spam.pyguarda el resultado: una lista de identificadores de publicaciones señaladas y un motivo.
El README de X describe la carpeta grox/ como código que se ejecuta a medida que se publican las publicaciones, con clasificadores para categorías como el spam. El nuevo plan está registrado en los mismos generadores de flujo que los demás flujos de clasificación de respuestas de X.
El archivo de tareas se modificó de nuevo el 8 de septiembre de 2026: su paso de escritura llama ahora a una sola función de publicación en lugar de dos escrituras separadas. El valor que escribe sigue siendo 0.0.
¿Qué respuestas puede atacar el filtro «multi-step reply spam»?
Gratis, sin inicio de sesión, resultados en segundos.
El filtro (TaskMultiStepReplySpamFilter) selecciona una respuesta solo cuando se cumplen todas estas condiciones:
- La publicación es una respuesta con ancestros, y ninguno de ellos se borró.
- Su padre directo es una publicación del mismo autor: la cuenta se responde a sí misma.
- Está al menos 2 niveles por debajo de la publicación raíz.
- Su autor no es el autor de la publicación raíz.
- El autor de la publicación raíz tiene al menos 1.000 seguidores (
FOLLOWER_COUNT_THRESHOLD_FOR_SPAM_DETECTION = 1000). Por debajo, el código omite la respuesta con el motivolow_blast_radius.
La forma mínima que cumple las condiciones es una publicación de otra cuenta, una respuesta de la cuenta evaluada y una segunda respuesta de esa misma cuenta a su propia primera respuesta. El filtro nunca mira el número de seguidores de quien responde.
Una respuesta cuyo padre directo pertenece a otra persona se omite (parent_not_same_author). Lo mismo ocurre con cualquier respuesta bajo la propia publicación de quien responde (same_user_reply_as_root).
¿Qué cuentas deja fuera el filtro?
El filtro «multi-step reply spam» de X omite 5 tipos de casos antes de que se ejecute ningún modelo:
- Las respuestas escritas por las cuentas Grok o Gork.
- Los autores marcados como high page rank (versión 2), comprobados con
is_high_page_rank_v2_user. - Los autores con insignia gris, comprobados con
is_grey_badge_user. - Las respuestas bajo un autor raíz con menos de 1.000 seguidores.
- Los hilos en los que se borró una publicación ancestro, o en los que una publicación no tiene registro de autor.
Estos archivos no definen «high page rank» ni «insignia gris».
¿Cómo decide el modelo qué es spam?
El código de X muestra lo que recibe el modelo y lo que ocurre tras su respuesta, pero no los criterios que aplica. El evaluador está ligado al identificador de modelo oai-gemma4-26b-2, definido en constants.py.
El modelo lee:
- el perfil del autor de la respuesta (nombre, usuario, biografía y ubicación del perfil);
- el hilo como publicaciones numeradas, donde «Post 0» es la publicación raíz, marcada «never flag», y la última está marcada «the reply being evaluated»;
- de cada publicación, el usuario, el número de seguidores, el nombre visible, el texto, las URL y hasta 2 elementos multimedia;
- la biografía del autor raíz, añadida a la publicación raíz.
Un hilo con más de 10 ancestros se recorta a los 5 primeros y los 5 últimos (MAX_THREAD_SIZE = 10). El modelo responde en JSON: los índices de las publicaciones que considera spam y un motivo.
El prompt en sí no es público. prompts.py carga una plantilla llamada multi_step_reply_spam_system.j2, que falta en el repositorio, y el comentario del propio archivo dice que los prompts se excluyen para dificultar que se manipule el sistema. El README de X incluye los prompts de Grox entre los archivos que no publica.
¿Qué salvaguardas siguen a la respuesta del modelo?
Tres comprobaciones se ejecutan en este orden, y cada una puede borrar las señalizaciones:
- Si la respuesta más reciente no está entre las publicaciones señaladas, se descartan todas las señalizaciones.
- Se eliminan las publicaciones señaladas que escribieron otros autores.
- Si queda exactamente 1 publicación señalada, se descarta.
Una sanción exige, por tanto, al menos 2 publicaciones señaladas del mismo autor, con la respuesta más reciente incluida.
¿Qué ocurre con una respuesta que el filtro señala?
Por cada publicación señalada del hilo, el código de X aplica una etiqueta de seguridad de reply spam y publica una puntuación de clasificación de la respuesta de 0.0. El paso de escritura (TaskWriteMultiStepReplySpamReplyRanking) está desactivado fuera de producción mediante DisableTaskForNonProd.
Por cada publicación señalada, el código:
- aplica la etiqueta de seguridad
RiskyHighVizReply, salvo que el autor sea high page rank, tenga insignia gris o sea una cuenta de prueba (una puntuación de credibilidad de 62 o más cuenta como high page rank cuando existe); - publica una puntuación de clasificación de la respuesta de 0.0 con el motivo del modelo, recortado a sus últimos 500 caracteres.
El principal evaluador de clasificación de respuestas de la misma carpeta rechaza cualquier puntuación fuera de una escala de 0 a 3, así que 0 es el valor más bajo de esa escala. Cuando una publicación tiene un 0, el paso de escritura estándar de la clasificación de respuestas omite cualquier puntuación nueva que no sea inferior a la almacenada.
Estos archivos actúan sobre publicaciones concretas. No suspenden la cuenta ni la etiquetan en su conjunto.
Lo que los archivos publicados no muestran
El repositorio no muestra cómo usa una vista de conversación la puntuación o la etiqueta: una búsqueda del nombre de la puntuación solo la encuentra en la carpeta reply_spam. El nombre de etiqueta RiskyHighVizReply tampoco aparece en ninguna parte de la carpeta under-the-hood del repositorio, lista de etiquetas incluida, así que el código publicado no muestra ninguna entrada para ella en Under the Hood.
¿Cómo saber si tus respuestas están afectadas?
Para saber si tus respuestas están afectadas, mira dónde aparecen en la conversación. Un reply deboosting (menor posición de respuestas) significa que tus respuestas quedan al final de una conversación o escondidas tras «Mostrar más respuestas».
Shadowban Radar define esta prueba desde fuera. La menor posición de respuestas se detecta cuando X muestra una respuesta en la conversación leída en orden cronológico, pero la deja fuera de la vista predeterminada de esa misma conversación. La página sobre reply deboosting explica cómo comprobarlo a mano.
Una comprobación gratuita en Shadowban Radar hace esta prueba con cualquier usuario público, sin iniciar sesión. Muestra la posición de una respuesta, no la causa. Una respuesta mal clasificada puede deberse a varias señales, así que la comprobación no puede decir si este filtro la señaló.
Una respuesta que falta por completo en la conversación es otra restricción, un ghost ban.
¿Qué sugiere el código para evitarlo?
X no ha publicado los criterios del modelo, así que estos puntos se deducen solo de las condiciones del filtro.
- Decirlo una sola vez. El filtro solo actúa cuando se señalan al menos 2 publicaciones del mismo autor, y una respuesta aislada bajo la publicación de otra persona no puede cumplir las condiciones. Fusionar varias respuestas cortas en una evita la cadena que busca el filtro.
- Poner el detalle adicional en tu propia publicación. Un seguimiento, un enlace o una explicación más larga pueden ir en tu propia publicación o hilo: las respuestas bajo tu propia publicación nunca se evalúan (
same_user_reply_as_root). - Responder a otras personas, no a ti mismo. Una respuesta cuyo padre directo es la publicación de otra cuenta queda fuera del filtro (
parent_not_same_author). - Una cadena se juzga en conjunto. El modelo lee todo el hilo de una vez, y cada publicación señalada del mismo autor recibe su propia puntuación de 0.
Los archivos de reply_spam no contienen ningún paso que retire una etiqueta o suba un 0 una vez escrito.
Fuentes
Leído el 7 de octubre de 2026 en el repositorio xai-org/x-algorithm, en el commit 78460ca. Los 4 archivos del filtro se añadieron en el commit 9b0dc31 el 4 de septiembre de 2026.
- plan_multi_step_reply_spam.py: los 4 pasos y su orden.
- task_multi_step_reply_spam.py: elegibilidad, detección y escritura.
- classifier_multi_step_reply_spam.py: el hilo que recibe el modelo y las 3 salvaguardas.
- state_multi_step_reply_spam.py: el resultado almacenado.
- task_write.py: la función de etiqueta y la escritura estándar de la clasificación de respuestas.
- README.md: la descripción de
grox/y la lista de archivos no publicados. - Commit 9b0dc31: 4 de septiembre de 2026.
Shadowban Radar no está afiliado a X Corp. Para ver cómo se relaciona el informe de X con una comprobación en vivo, consulta Under the Hood de X.