Filtro «multi-step reply spam» do X: o que o código mostra (2026)
Em 4 de setembro de 2026, o X adicionou um filtro contra correntes de autorrespostas sob contas com 1.000 seguidores ou mais. O que o código público faz.
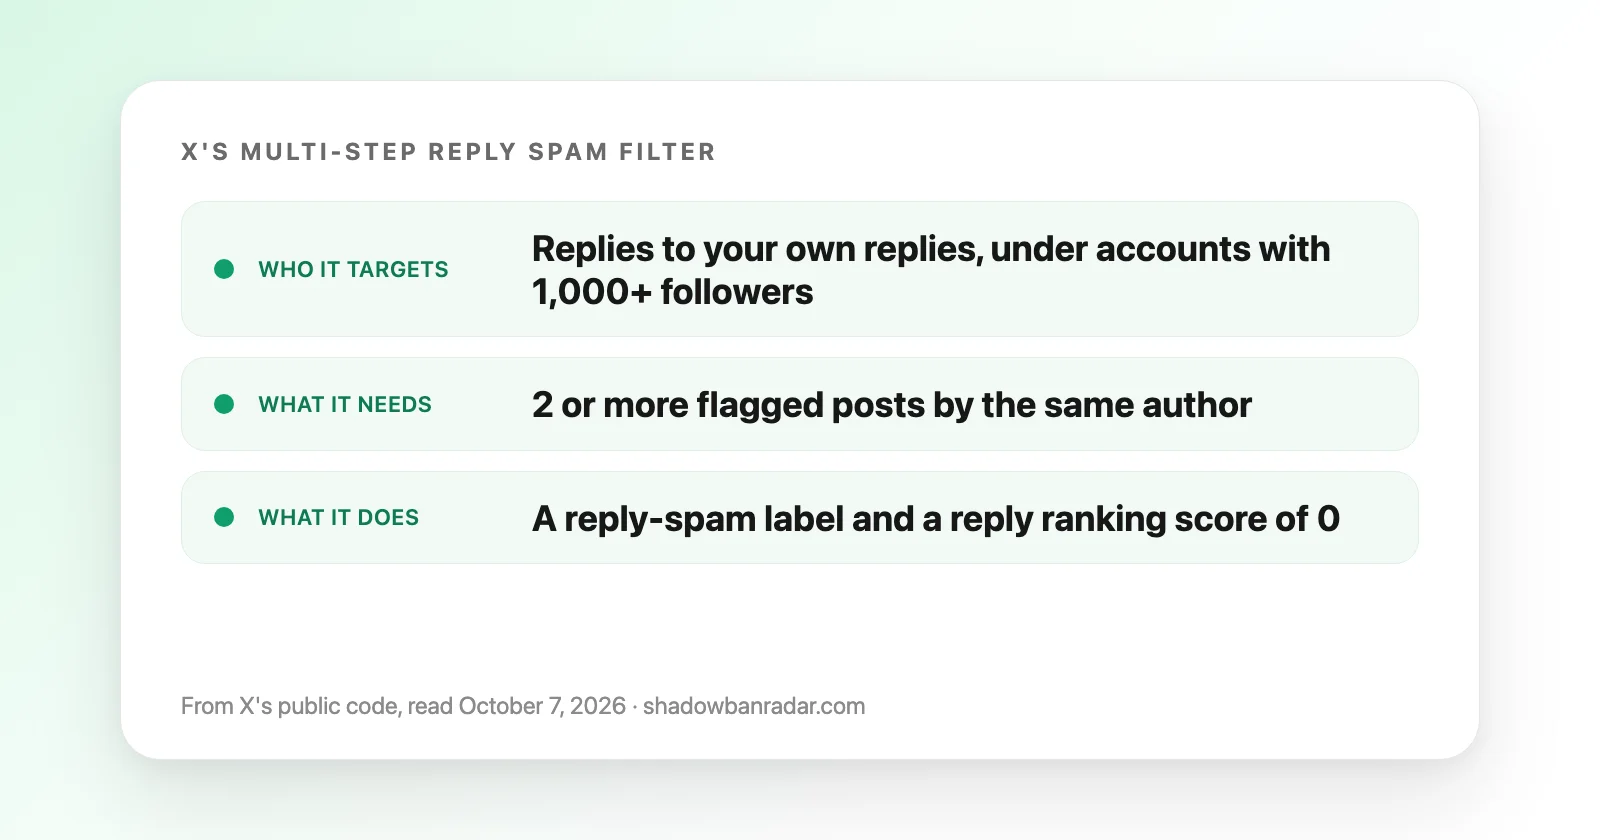
O código aberto do X contém um filtro, adicionado em 4 de setembro de 2026, voltado a correntes de autorrespostas sob posts de contas com pelo menos 1.000 seguidores. Quando um modelo de IA sinaliza pelo menos 2 posts do mesmo autor numa corrente assim, o código do X dá a cada um deles um rótulo de reply spam e uma pontuação de classificação da resposta igual a 0.
O que o X adicionou ao seu código aberto em 4 de setembro de 2026?
O repositório público xai-org/x-algorithm ganhou em 4 de setembro de 2026 um novo fluxo contra spam em respostas, multi_step_reply_spam. O commit adicionou quatro arquivos em grox/flows/reply_spam/:
plan_multi_step_reply_spam.pyencadeia 4 etapas: um filtro de elegibilidade, o carregamento de mídia, a detecção de spam e uma etapa de gravação.task_multi_step_reply_spam.pycontém o filtro, a etapa de detecção e a etapa de gravação.classifier_multi_step_reply_spam.pymonta a conversa que o modelo lê, interpreta a resposta dele e aplica 3 salvaguardas.state_multi_step_reply_spam.pyguarda o resultado: uma lista de IDs de posts sinalizados e um motivo.
O README do X descreve a pasta grox/ como código que roda à medida que os posts são publicados, com classificadores para categorias como spam. O novo plano está registrado nos mesmos geradores de fluxo dos outros fluxos de classificação de respostas do X.
O arquivo de tarefas foi editado de novo em 8 de setembro de 2026: sua etapa de gravação agora chama uma única função de publicação, em vez de duas gravações separadas. O valor gravado continua sendo 0.0.
Quais respostas o filtro «multi-step reply spam» pode atingir?
Grátis, sem login, resultado em segundos.
O filtro (TaskMultiStepReplySpamFilter) seleciona uma resposta somente quando todas estas condições são verdadeiras:
- O post é uma resposta com ancestrais, e nenhum deles foi apagado.
- Seu pai direto é um post do mesmo autor: a conta está respondendo a si mesma.
- Ele fica pelo menos 2 níveis abaixo do post raiz.
- Seu autor não é o autor do post raiz.
- O autor do post raiz tem pelo menos 1.000 seguidores (
FOLLOWER_COUNT_THRESHOLD_FOR_SPAM_DETECTION = 1000). Abaixo disso, o código ignora a resposta com o motivolow_blast_radius.
A menor forma que se qualifica é um post de outra conta, uma resposta da conta avaliada e uma segunda resposta dessa mesma conta à sua própria primeira resposta. O filtro nunca olha o número de seguidores de quem responde.
Uma resposta cujo pai direto pertence a outra pessoa é ignorada (parent_not_same_author). O mesmo vale para qualquer resposta sob o próprio post de quem responde (same_user_reply_as_root).
Quais contas o filtro isenta?
O filtro «multi-step reply spam» do X ignora 5 tipos de caso antes de qualquer modelo rodar:
- Respostas escritas pelas contas Grok ou Gork.
- Autores marcados como high page rank (versão 2), verificados com
is_high_page_rank_v2_user. - Autores com selo cinza, verificados com
is_grey_badge_user. - Respostas sob um autor raiz com menos de 1.000 seguidores.
- Conversas em que um post ancestral foi apagado, ou em que um post não tem registro de autor.
Esses arquivos não definem «high page rank» nem «selo cinza».
Como o modelo decide o que é spam?
O código do X mostra o que o modelo recebe e o que acontece depois da resposta, mas não os critérios que ele aplica. O avaliador está ligado ao identificador de modelo oai-gemma4-26b-2, definido em constants.py.
O modelo lê:
- o perfil do autor da resposta (nome, usuário, bio e local do perfil);
- a conversa como posts numerados, em que «Post 0» é o post raiz, marcado «never flag», e o último post é marcado «the reply being evaluated»;
- de cada post, o usuário, o número de seguidores, o nome de exibição, o texto, as URLs e até 2 mídias;
- a bio do autor raiz, adicionada ao post raiz.
Uma conversa com mais de 10 ancestrais é cortada para os 5 primeiros e os 5 últimos (MAX_THREAD_SIZE = 10). O modelo responde em JSON: os índices dos posts que considera spam e um motivo.
O prompt em si não é público. O prompts.py carrega um modelo chamado multi_step_reply_spam_system.j2, que não está no repositório, e o comentário do próprio arquivo diz que os prompts são excluídos para dificultar a manipulação do sistema. O README do X lista os prompts do Grox entre os arquivos que não publica.
Quais salvaguardas seguem a resposta do modelo?
Três verificações rodam nesta ordem, e cada uma pode apagar as sinalizações:
- Se a resposta mais recente não está entre os posts sinalizados, todas as sinalizações são descartadas.
- Os posts sinalizados escritos por outros autores são removidos.
- Se sobrar exatamente 1 post sinalizado, ele é descartado.
Uma penalidade exige, portanto, pelo menos 2 posts sinalizados do mesmo autor, incluindo a resposta mais recente.
O que acontece com uma resposta sinalizada pelo filtro?
Para cada post sinalizado da conversa, o código do X aplica um rótulo de segurança de reply spam e publica uma pontuação de classificação da resposta igual a 0.0. A etapa de gravação (TaskWriteMultiStepReplySpamReplyRanking) fica desativada fora de produção por DisableTaskForNonProd.
Para cada post sinalizado, o código:
- aplica o rótulo de segurança
RiskyHighVizReply, a menos que o autor seja high page rank (62 ou mais de credibilidade, quando existe pontuação), tenha selo cinza ou seja uma conta de teste; - publica uma pontuação de classificação da resposta igual a 0.0 com o motivo dado pelo modelo, cortado nos últimos 500 caracteres.
O principal avaliador de classificação de respostas da mesma pasta rejeita qualquer pontuação fora de uma escala de 0 a 3, então 0 é o menor valor dessa escala. Quando um post tem um 0, a etapa de gravação padrão da classificação de respostas ignora qualquer pontuação nova que não seja menor que a armazenada.
Esses arquivos agem em posts individuais. Não suspendem a conta nem a rotulam como um todo.
O que os arquivos publicados não mostram
O repositório não mostra como uma visualização de conversa usa a pontuação ou o rótulo: uma busca pelo nome da pontuação só a encontra na pasta reply_spam. O nome de rótulo RiskyHighVizReply também não aparece em lugar nenhum da pasta under-the-hood do repositório, lista de rótulos incluída, então o código publicado não mostra nenhuma entrada para ele no Under the Hood.
Como saber se suas respostas são afetadas?
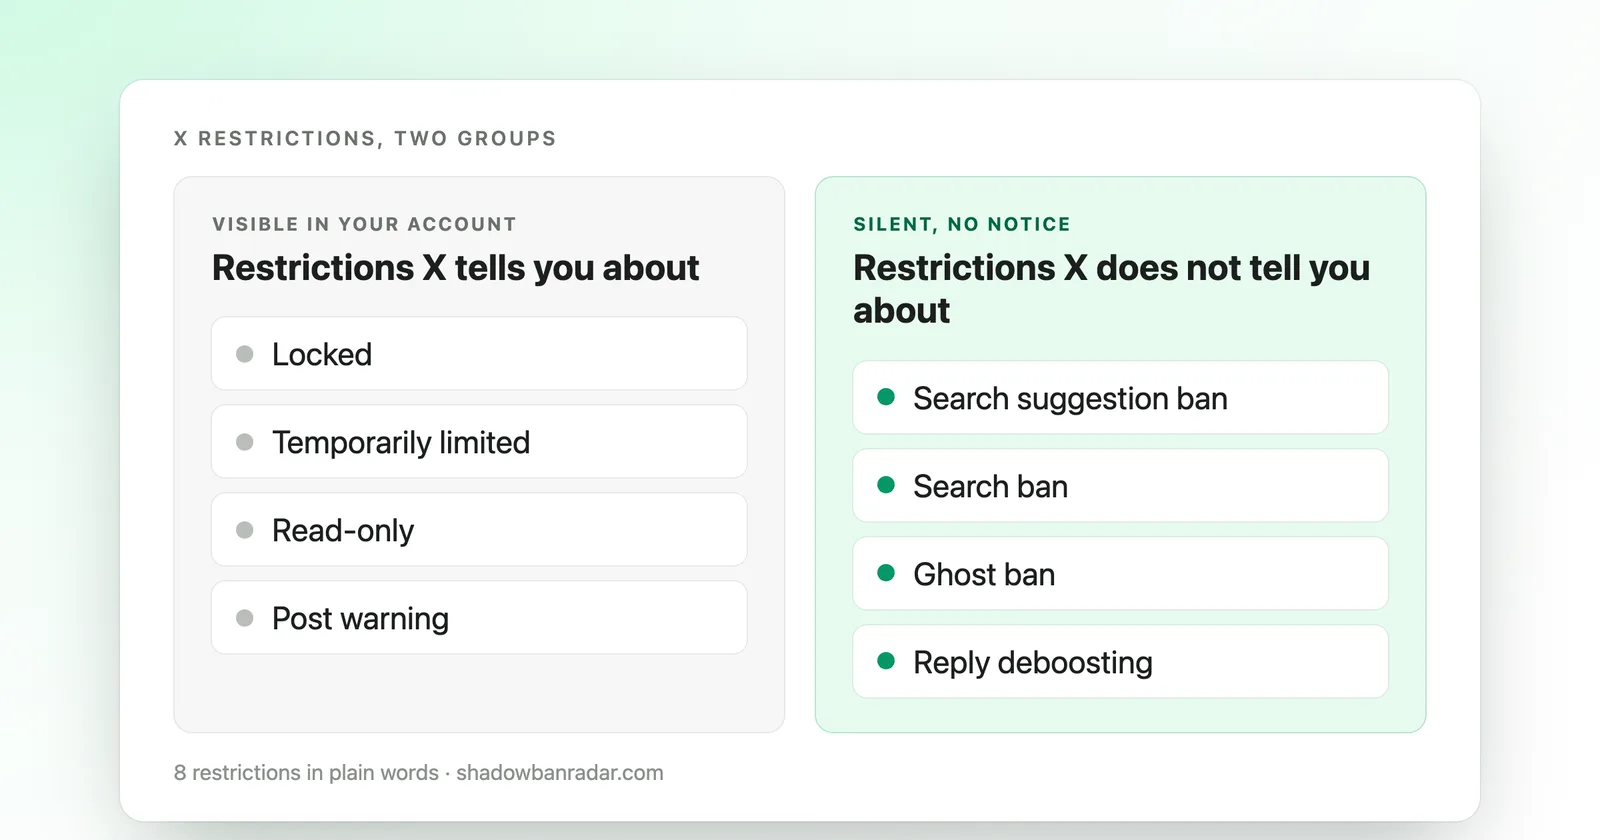
Para saber se suas respostas são afetadas, veja onde elas aparecem na conversa. Um reply deboosting (rebaixamento de respostas) significa que suas respostas ficam no fim de uma conversa ou escondidas atrás de “Mostrar mais respostas”.
O Shadowban Radar define esse teste de fora. O rebaixamento de respostas é detectado quando o X exibe uma resposta na conversa lida em ordem cronológica, mas a deixa de fora da visualização padrão dessa mesma conversa. A página sobre reply deboosting explica como verificar manualmente.
Um teste gratuito no Shadowban Radar faz essa verificação em qualquer usuário público, sem login. Ele mostra a posição de uma resposta, não a causa. Uma resposta mal classificada pode vir de vários sinais, então o teste não consegue dizer se este filtro a sinalizou.
Uma resposta que some por completo da conversa é outra restrição, um ghost ban.
O que o código sugere fazer a respeito?
O X não publicou os critérios do modelo, então estes pontos decorrem apenas das condições do filtro.
- Dizer uma vez só. O filtro só age quando pelo menos 2 posts do mesmo autor são sinalizados, e uma resposta isolada sob o post de outra pessoa não pode se qualificar. Juntar várias respostas curtas em uma evita a corrente que o filtro procura.
- Pôr o detalhe extra no seu próprio post. Uma continuação, um link ou uma explicação mais longa podem ir no seu próprio post ou thread: respostas sob o seu próprio post nunca são avaliadas (
same_user_reply_as_root). - Responder às pessoas, não a si mesmo. Uma resposta cujo pai direto é o post de outra conta fica fora do filtro (
parent_not_same_author). - Uma corrente é julgada em conjunto. O modelo lê a conversa inteira de uma vez, e cada post sinalizado do mesmo autor recebe sua própria pontuação 0.
Os arquivos de reply_spam não contêm nenhuma etapa que retire um rótulo ou suba um 0 depois de gravado.
Fontes
Lido em 7 de outubro de 2026 no repositório xai-org/x-algorithm, no commit 78460ca. Os 4 arquivos do filtro foram adicionados no commit 9b0dc31 em 4 de setembro de 2026.
- plan_multi_step_reply_spam.py: as 4 etapas e sua ordem.
- task_multi_step_reply_spam.py: elegibilidade, detecção e gravação.
- classifier_multi_step_reply_spam.py: a conversa dada ao modelo e as 3 salvaguardas.
- state_multi_step_reply_spam.py: o resultado armazenado.
- task_write.py: a função de rótulo e a gravação padrão da classificação de respostas.
- README.md: a descrição de
grox/e a lista de arquivos não publicados. - Commit 9b0dc31: 4 de setembro de 2026.
O Shadowban Radar não é afiliado à X Corp. Para ver como o relatório do X se relaciona com um teste em tempo real, veja o Under the Hood do X.